附件数据提取
发票就在附件里。无需把数字输入两遍。
Kerna 读取当前邮件中的 PDF、DOC 或 XLS,提取您指定的字段,并生成整洁的一行数据。无需配置解析器、编写规则,也无需离开收件箱。
如何从附件中提取数据
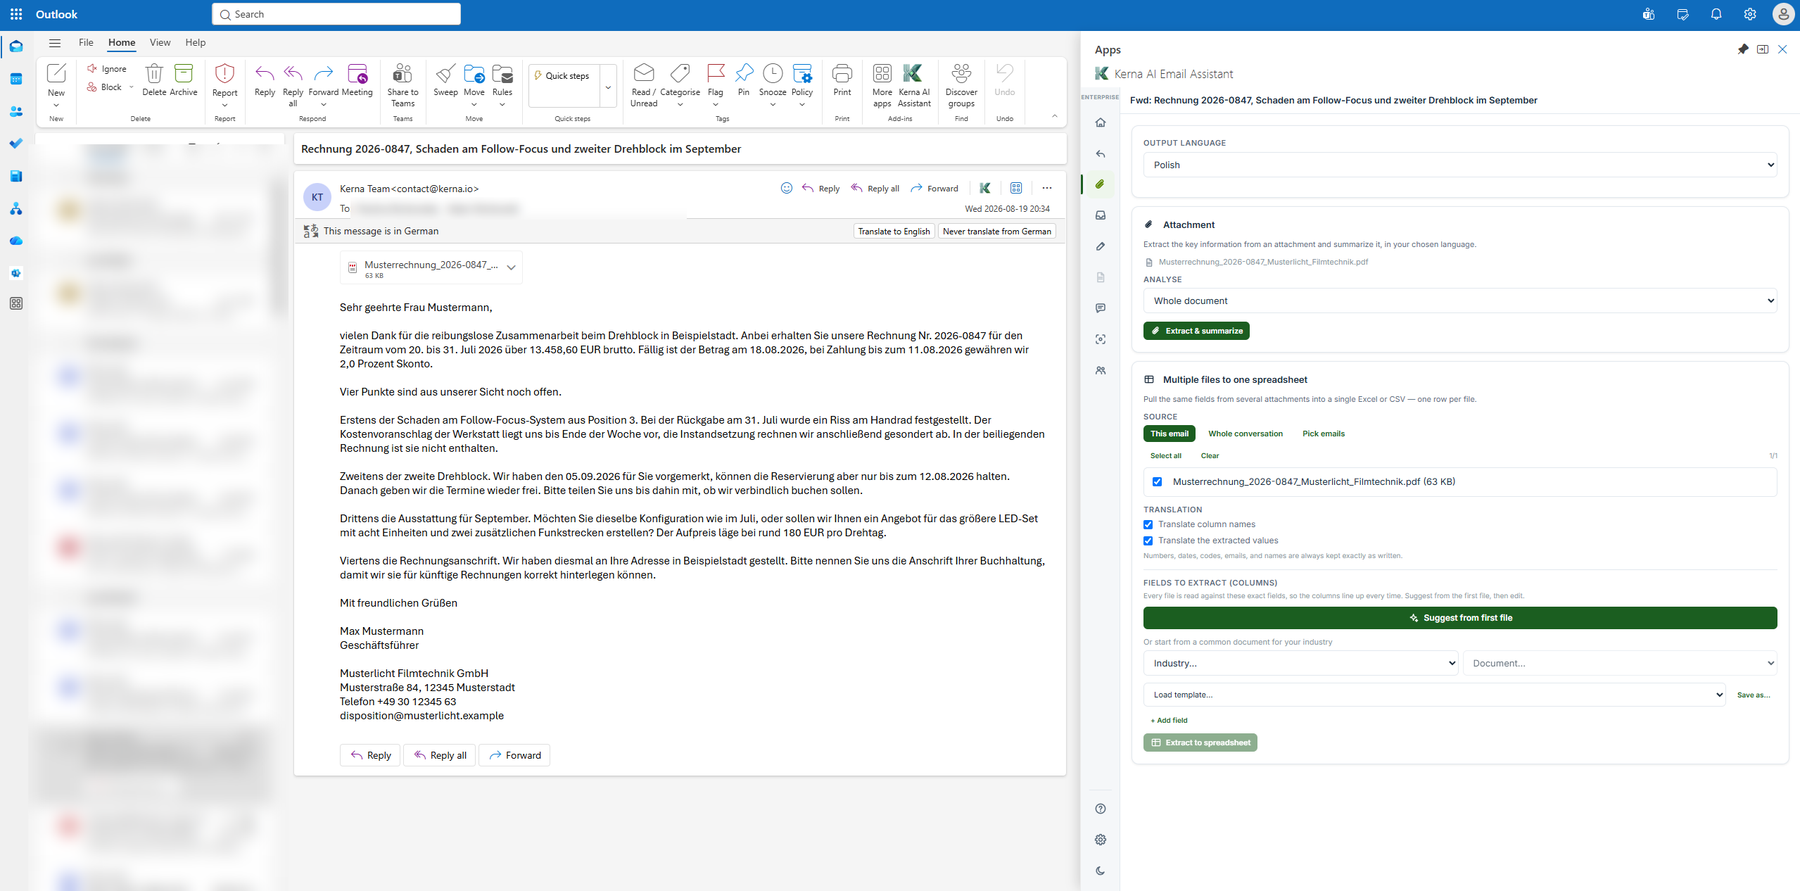
- 1
打开邮件
打开包含发票、合同或交货单的那封邮件。Kerna 已经位于侧边栏中,因此没有单独的上传步骤,也不必再打开第二个工具——您直接在附件所在的邮件里指向它。
- 2
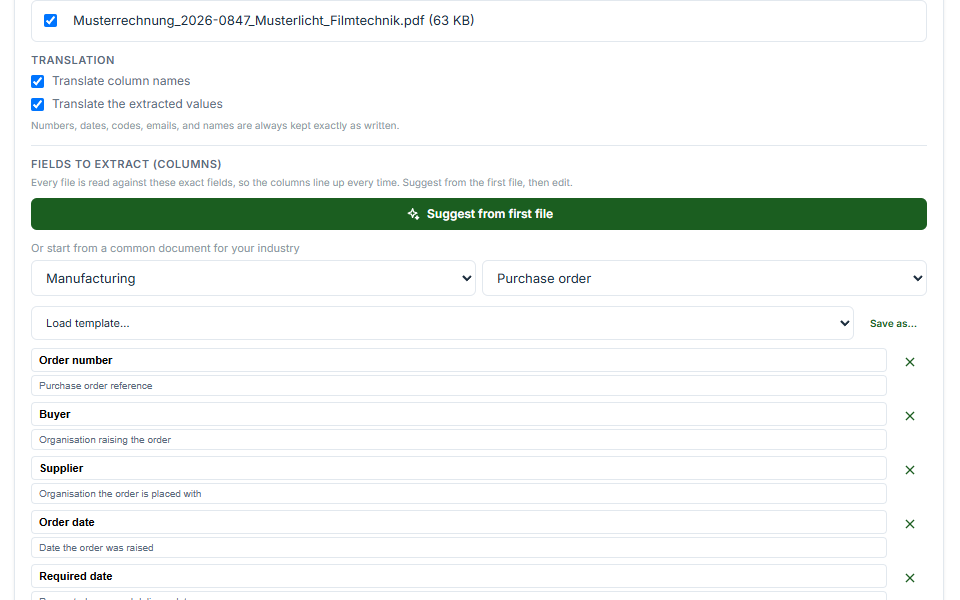
选择字段集
选择与文档匹配的现成字段集。覆盖 20 个行业、每个行业 5 种文档类型,因此字段在您开始之前就已命名,无需从零开始定义。
- 3
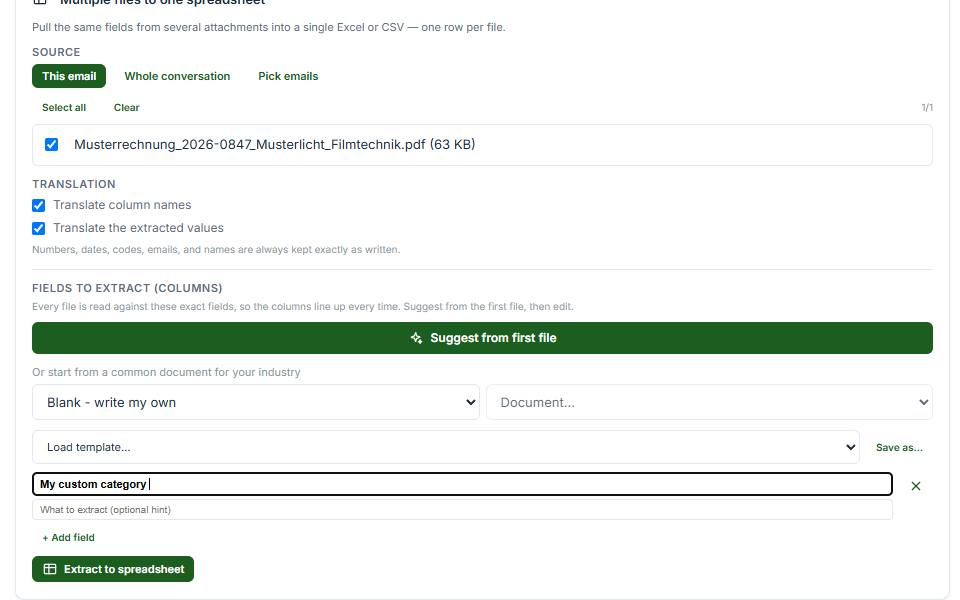
补充贵公司需要的字段
现成字段集覆盖的是常见情况,而不是您的具体情况。添加自定义字段后,Kerna 也会查找这些字段,让您的财务团队真正依赖的内部编号与发票编号一起提取出来。
- 4
导出
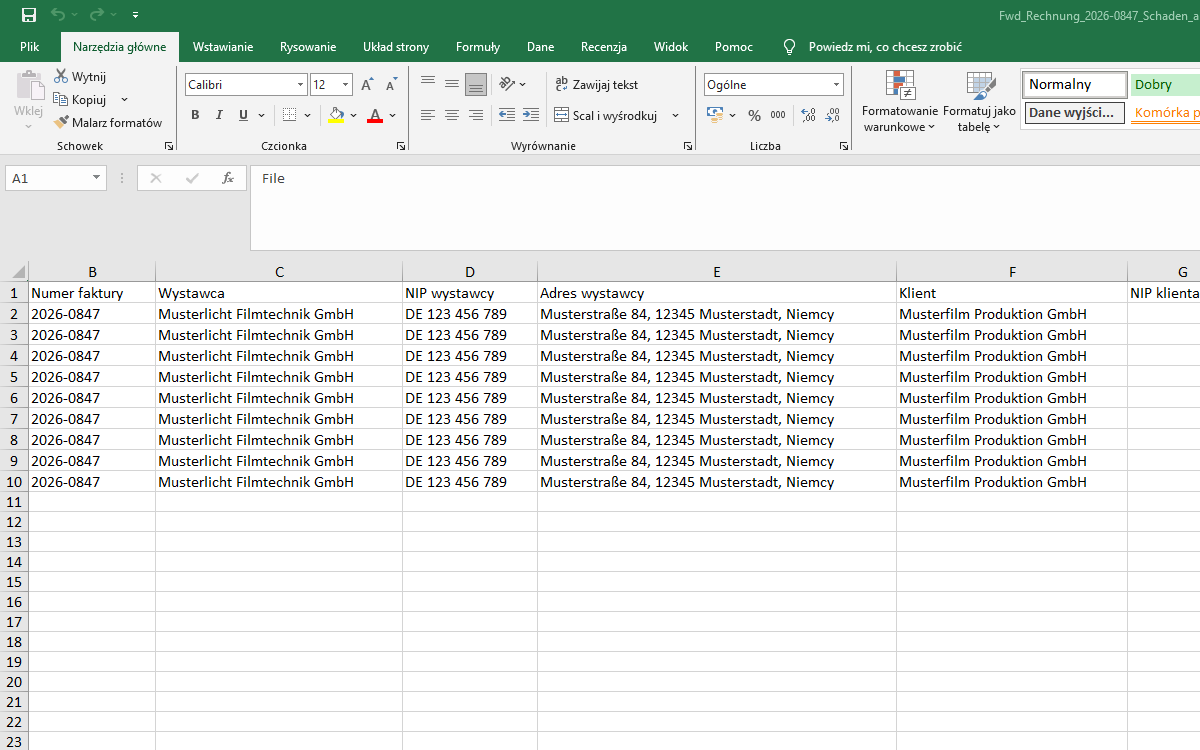
Gmail 会生成 Google Sheet 或 Google Doc。Outlook 会生成 Excel、Word 或 CSV 文件。每次导出都会创建新文件,而不是追加到您已有的文件中。使用这些数值之前,请对照文档核对一遍。
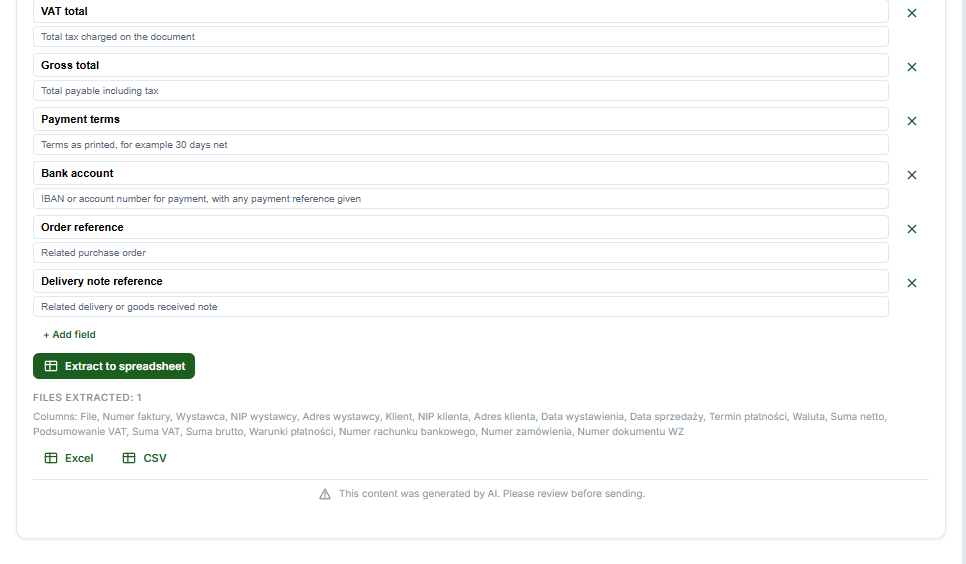

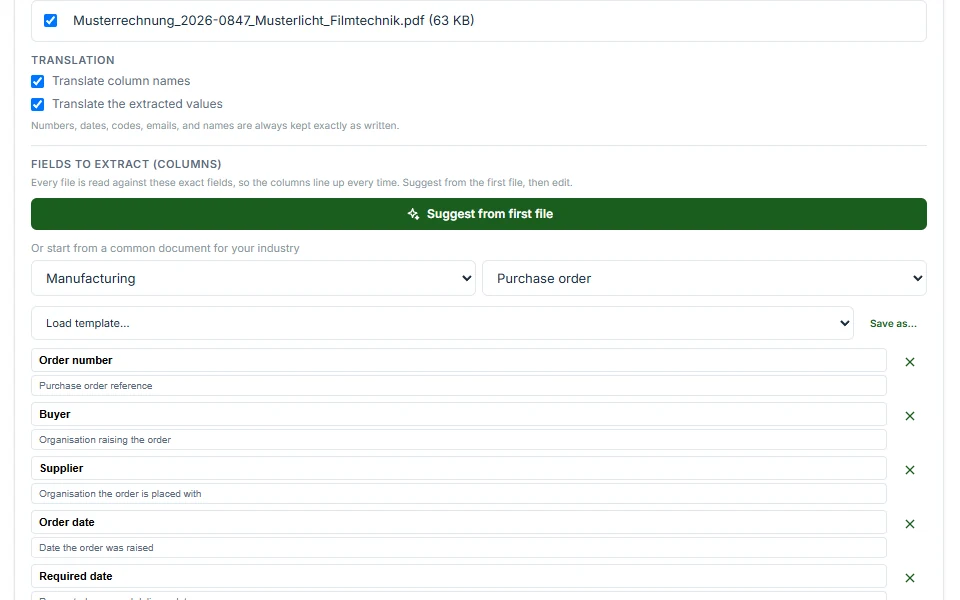


最终得到什么
您要的字段,会放在一个可以直接使用的文件里——字段名称与现成字段集中的命名一致,每份文档一行。
生成什么,以及保存在哪里
这两个环境在此处的工作方式不同。在围绕它规划工作流程前,您需要知道自己使用的是哪一个。
在 Gmail 中
- 处理对象
- 一次一个附件
- 导出至
- Google Sheets 或 Google Docs
- 每次导出
- 新文件,绝不会追加到现有文件
在 Outlook 中
- 处理对象
- 一次处理邮件中的所有附件,或只处理一个
- 导出至
- Excel、Word 或 CSV
- 每次导出
- 新文件,绝不会追加到现有文件
可以处理哪些文件
PDF 最常见,DOC 和 XLS 也可以处理。商务邮件中的大多数附件都属于这三种类型之一。
100 个现成字段集,而不是空白输入框
20 个行业,每个行业 5 种文档类型。字段在开始前就已为您命名,这正是今天就能使用的工具与“以后再配置”的工具之间的区别。
支持您的自定义字段
添加现成字段集未覆盖的内容:ERP 所需的采购订单行、地点代码,或公司外部人员不会想到要查找的合同编号。
文档会去哪里
应用运行在比利时的 Cloud Run 上,数据存储使用波兰的 Firestore。模型处理由 OpenAI Ireland Limited 根据已签署的零数据保留协议提供;个人数据会在内容到达模型前被移除。这一点在此处尤其重要,因为发票不仅包含您自己的商业条款,也包含他人的商业条款。
常见问题
- 如何从邮件中的 PDF 发票提取数据?
- 在安装了 Kerna 的 Gmail 或 Outlook 中打开邮件,选择与文档匹配的现成字段集,补充其中尚未命名的字段,然后导出。Gmail 生成 Google Sheet 或 Doc,Outlook 生成 Excel、Word 或 CSV 文件,每次都是新文件。
- Kerna 可以从哪些文件类型中提取数据?
- PDF、DOC 和 XLS。
- 可以同时从多个附件中提取数据吗?
- 在 Outlook 中可以:一次处理邮件中的所有附件,也可以只处理一个。在 Gmail 中一次处理一个附件。
- 可以选择要提取的字段吗?
- 可以。每个现成字段集都已包含命名好的字段,您还可以在此基础上根据公司的具体工作方式添加自定义字段。
- 它会覆盖现有电子表格吗?
- 不会。每次导出都会创建新文件。您已有的内容不会被追加、覆盖或重新排序。
- 这与 Parseur 或 Mailparser 等邮件解析器有什么不同?
- 基于规则的解析器只需设置一次,之后便自行运行:您预先定义要提取的内容,它就会在无人在场的情况下处理收到的文件。这适合大量外观一致的文档。Kerna 的做法正好相反。您打开一封邮件,指向附件,一次性取出字段,事先无需任何配置——100 个现成字段集就是配置。它适合这样的情形:文档来自不同发件人、形式各异,而且无论如何都要有人过目。
- 附件会离开我的邮箱吗?
- Kerna 运行在比利时的 Cloud Run 上,使用波兰的 Firestore,并且只有在您点击按钮后才会读取附件。个人数据会在 Kerna 内部匿名化,然后才发送给模型。模型处理由 OpenAI Ireland Limited 根据已签署的零数据保留协议提供;正如我们的隐私政策所述,某些子处理者可能依据 Standard Contractual Clauses 在 EEA 之外处理数据。响应返回后,文档内容不会被保留。
从下一张发票开始试用
直接在您已经使用的收件箱中免费开始。无需迁移,无需银行卡;个人数据会在到达模型前被匿名化。